

BrowserAct翻译站点
BrowserAct是一款无代码AI网页数据采集与浏览器自动化平台,通过自然语言创建可重复运行的Web Scraper Bot,并提供云端浏览器、代理、CAPTCHA处理、自动修复、API、Webhook和MCP等...
标签:数据抓取AI Web Scraper AI数据采集 AI爬虫 AI网页爬虫 BrowserAct BrowserAct官网 BrowserAct是什么 Web Scraping 无代码爬虫 网页抓取 网页数据采集 自动化爬虫BrowserAct是什么
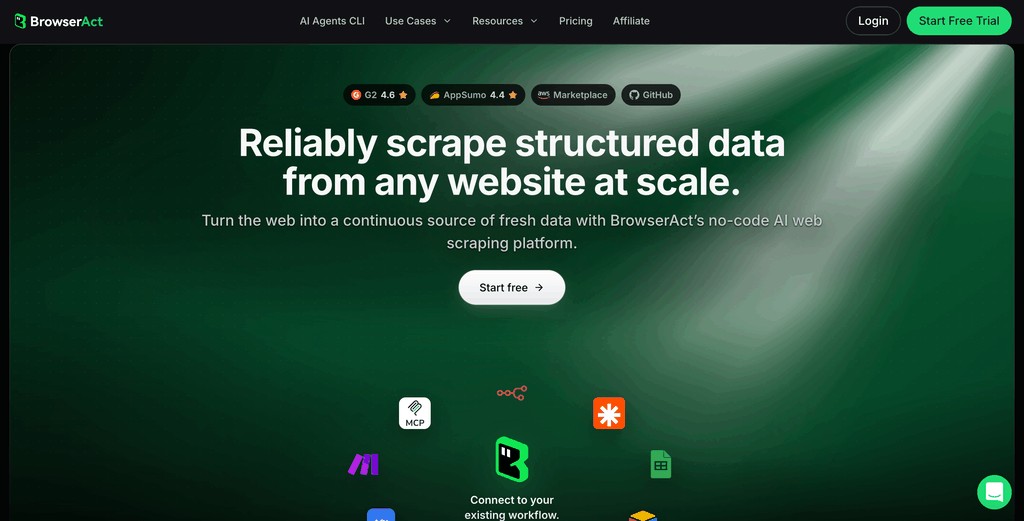
BrowserAct 是面向数据采集、网页自动化和 AI Agent 场景的 Web 数据平台。用户无需编写爬虫代码,只需要描述希望从网站获取的数据,BrowserAct AI Agent 就可以分析目标网站、识别数据字段并生成可运行的 Bot。创建完成后,可以重复运行 Bot 获取最新数据,并将结果输出为 CSV、JSON 或通过 API、Webhook 等方式连接到现有业务流程。
BrowserAct 的核心理念是将网站转换为可以持续获取结构化数据的数据源,同时由平台负责浏览器环境、身份、代理、CAPTCHA 处理和任务调度等基础设施。
BrowserAct核心功能
BrowserAct AI网页采集
BrowserAct 可以通过自然语言创建网页数据采集任务。用户只需要输入目标网站和需要获取的数据,例如“获取某网站20个商品的名称、价格、库存和评分”,AI Agent 会分析网站结构并生成对应的 Bot。官方示例中,Bot 创建过程消耗 320 Credits,之后每次运行示例任务消耗 20 Credits。
BrowserAct无代码爬虫
BrowserAct 将网页采集流程封装为无代码操作,用户不需要自行编写 XPath、CSS Selector 或传统爬虫程序。AI Agent 会选择合适的采集方式、识别数据字段并生成可以重复运行的 Bot。
BrowserAct Bot
创建完成的采集任务可以保存为 Bot,并通过输入参数重复运行。例如可以改变关键词、网站 URL、商品类别、地区或采集数量,而不需要重新创建整个爬虫。
BrowserAct动态网页采集
BrowserAct 基于真实浏览器运行 Bot,可以处理动态网页以及需要页面交互的采集场景,适合电子商务、价格监控、竞品分析等数据采集任务。
BrowserAct自动处理CAPTCHA
平台提供 CAPTCHA 处理能力,可以处理包括 reCAPTCHA、Turnstile、DataDome 等常见验证场景。官方定价页面目前标注 CAPTCHA Solver 的成功率为 99%+。
BrowserAct浏览器指纹
BrowserAct 提供浏览器指纹隔离能力,为 Chromium 浏览器会话维护独立的设备身份。官方介绍包含 30 多项浏览器指纹属性,并保持设备身份的一致性。
BrowserAct代理IP
平台提供全球住宅代理,可以根据国家选择访问环境,并支持轮换代理和持久化会话。动态住宅代理当前按照流量计费,静态代理则按照代理和使用周期计费。
BrowserAct登录浏览器
BrowserAct 支持新的浏览器会话,也支持保持已经登录的网站浏览器配置,从而适用于需要账号登录才能访问的数据采集任务。
BrowserAct云端浏览器
Bot 可以直接运行在 BrowserAct 云端浏览器环境中,不需要用户自己搭建浏览器服务器。平台支持任务调度、并发运行以及后台执行。
BrowserAct自动修复
当目标网站页面结构发生变化时,BrowserAct 可以重新识别页面中的数据位置并自动修复采集逻辑,从而减少传统爬虫因为网页改版导致任务失效的维护工作。
BrowserAct多模态数据采集
BrowserAct 支持图片、文本和文件等输入,同时可以输出 CSV、JSON、图片、视频和其他文件格式,可以用于更加复杂的数据采集任务。
BrowserAct结构化数据输出
平台可以将网页内容转换为结构化数据,并保持每次运行的数据字段和输出结构一致,方便后续进入数据库、分析工具或自动化工作流。
BrowserAct API
BrowserAct 支持通过 API 获取采集结果,可以将网页数据接入企业内部系统、数据平台或其他软件。
BrowserAct Webhook
采集任务完成后可以通过 Webhook 将结果发送到其他系统,实现网页数据采集与业务流程之间的自动连接。
BrowserAct MCP
BrowserAct 支持 MCP,可以让 AI Agent 获得浏览器和网页数据采集能力,从而将网页操作能力连接到 AI 工作流中。官网目前将 MCP 列为数据工作流连接方式之一。
BrowserAct工作流集成
BrowserAct 可以连接 Make、n8n、Zapier、Google Sheets 和 Airtable 等工具,让采集结果进入现有自动化流程。
BrowserAct产品优势
自然语言创建爬虫
BrowserAct 将传统网页采集中的技术配置转换为自然语言任务描述,用户可以直接告诉 AI 需要哪些数据,再由 Agent 创建采集 Bot。
无需自行维护浏览器基础设施
浏览器环境、身份、代理、CAPTCHA处理和任务调度均可以由 BrowserAct 托管,用户可以直接运行采集任务。
适合持续数据采集
Bot 可以重复运行,而不是只能完成一次性网页抓取,因此适合价格监控、商品数据、竞品信息、客户数据和市场研究等持续性任务。
网页变化自动修复
网站改版后,BrowserAct 可以尝试重新识别数据位置并修复采集逻辑,减少传统选择器爬虫需要人工维护的问题。
云端与本地Agent结合
BrowserAct 提供两种使用方式:一方面可以直接在 BrowserAct Cloud 运行 Bot,另一方面可以为用户自己的本地 Agent 提供浏览器能力。
连接现有AI和自动化生态
通过 API、Webhook、MCP、Make、n8n 和 Zapier 等方式,BrowserAct 可以进入现有的数据处理和 AI Agent 工作流。
BrowserAct应用场景
BrowserAct电商数据采集
可以采集商品名称、价格、库存、评分、卖家、促销信息等数据,用于商品研究和价格监控。
BrowserAct竞品分析
可以持续采集竞争产品的价格、评论、产品更新和其他公开信息,为竞品研究提供结构化数据。
BrowserAct市场调研
可以从公开网站采集产品、客户、评论、市场和行业信息,用于市场研究和数据分析。
BrowserAct线索获取
可以采集企业名称、类别、地点、评分、网站和公开联系方式等商业数据,用于销售线索和业务数据建设。
BrowserAct价格监控
可以定期运行 Bot 获取商品价格、库存和促销信息,并将结果输出到表格或其他业务系统。
BrowserAct社交媒体数据
可以用于采集公开平台上的创作者、内容、评论、广告以及其他公开数据。
BrowserAct招聘数据
可以持续获取公开招聘网站中的职位和市场信息,用于人才市场分析。
BrowserAct数据管道
企业可以将 BrowserAct 作为网页数据入口,把网站数据通过 API、Webhook、CSV、JSON、Make 或 n8n 等方式进入现有数据处理流程。
BrowserAct使用教程
第一步:进入BrowserAct
打开 BrowserAct 官方网站并注册账号。
第二步:描述采集需求
输入目标网站以及希望获取的数据,例如“获取该网站所有商品的名称、价格、库存和评分”。
第三步:AI创建Bot
BrowserAct AI Agent 会分析目标网站,识别需要采集的数据字段,并生成可重复运行的 Bot。
第四步:测试Bot
检查生成的 Bot 和数据字段,并运行任务确认采集结果。
第五步:运行Bot
输入关键词、URL、数量等参数后运行 Bot,获取最新结构化数据。
第六步:导出数据
可以将结果导出为 CSV 或 JSON,也可以通过 API、Webhook、Google Sheets、Airtable、Make、n8n 和 Zapier 等方式继续处理。
第七步:设置自动化任务
对于需要持续更新的数据,可以重复运行 Bot,并通过云端浏览器执行定时采集任务。
BrowserAct收费标准
BrowserAct 当前采用 Credits积分制,提供 Free Trial、Basic、Essential 和 Advanced 等方案。免费方案为 $0/月,注册可获得 200 Credits、2次 Agent Build、2个并发任务和5个免费本地浏览器;Basic 为 $16/月,包含10,000 Monthly Credits;Essential 为 $70/月,包含50,000 Monthly Credits;Advanced 为 $120/月,包含100,000 Monthly Credits。按年付费时,官网当前显示 Basic 为 $13/月、Essential 为 $56/月、Advanced 为 $96/月。
| 套餐 | 月付价格 | Monthly Credits | 并发任务 |
|---|---|---|---|
| Free Trial | $0/月 | 注册赠200 Credits | 2 |
| Basic | $16/月 | 10,000 | 10 |
| Essential | $70/月 | 50,000 | 20 |
| Advanced | $120/月 | 100,000 | 40 |
BrowserAct 同时提供按资源使用量计费的基础设施服务,例如 Workflow Step 为 5 Credits/Step,Dynamic Proxy 为 5,000 Credits/GB,Local Fingerprint Browser 为 100 Credits/个;Cloud Browser 当前官网显示限时免费。
BrowserAct常见问题(FAQ)
BrowserAct是什么?
BrowserAct 是一款无代码 AI 网页数据采集和浏览器自动化平台,可以通过自然语言创建可重复运行的网页数据采集 Bot。
BrowserAct是爬虫工具吗?
是。BrowserAct 的核心能力之一就是 AI 网页数据采集,但与传统爬虫不同,它通过 AI Agent、真实浏览器、代理、浏览器指纹和自动修复等能力降低网页采集的开发和维护成本。
BrowserAct需要写代码吗?
基本不需要。用户可以直接使用自然语言描述数据需求,由 AI Agent 创建采集 Bot。
BrowserAct支持动态网页吗?
支持。BrowserAct 使用真实浏览器运行 Bot,可以处理支持的动态页面和页面交互流程。
BrowserAct支持CAPTCHA吗?
支持。平台提供 CAPTCHA Solver,可以处理 reCAPTCHA、Turnstile、DataDome 等常见验证。
BrowserAct支持代理IP吗?
支持。平台提供全球住宅代理,包括动态住宅代理和静态代理。
BrowserAct支持API吗?
支持。可以通过 API 和 Webhook 将采集结果连接到其他系统和工作流。
BrowserAct支持MCP吗?
支持。BrowserAct 当前将 MCP 列为数据工作流连接方式之一,可以将网页浏览和数据采集能力连接到 AI Agent。
BrowserAct支持n8n和Make吗?
支持。官方目前提供 Make、n8n 和 Zapier 等自动化工作流连接方式。
BrowserAct免费吗?
提供免费方案。注册可以获得200 Credits以及部分免费功能;付费方案从 Basic $16/月起。
BrowserAct适合哪些用户?
BrowserAct 主要适合需要网页数据采集、竞品研究、电商数据分析、价格监控、线索获取、市场调研和 AI Agent 浏览器能力的个人、开发者和企业团队。
相关导航

 皖公网安备34010202602243号